AI-читаемость корпоративного сайта: как структурированные данные Schema становятся техническим фундаментом GEO
Последние десять лет целью корпоративных сайтов был «визуальный удар» — эффектные баннеры, плавные анимации, изысканная вёрстка. Но сегодня, когда генеративный ИИ стал основным входом в информацию, этот эстетический стандарт перестаёт работать. AI-краулеру всё равно, красив ли ваш сайт, — его интересует одно: структурирована ли ваша информация, можно ли её точно извлечь и процитировать. Именно здесь — подлинная техническая отправная точка корпоративного GEO (оптимизации под генеративные движки) — AI-читаемость.
I. Почему традиционные сайты «невидимы» в AI-поиске
Мы провели аудит множества корпоративных сайтов и обнаружили общую закономерность: контента немало, но когда Doubao, DeepSeek, ChatGPT и другие ИИ отвечают на отраслевые вопросы, эти компании почти никогда не цитируются. Корень редко в «низком качестве контента», а в том, что «машина не понимает».
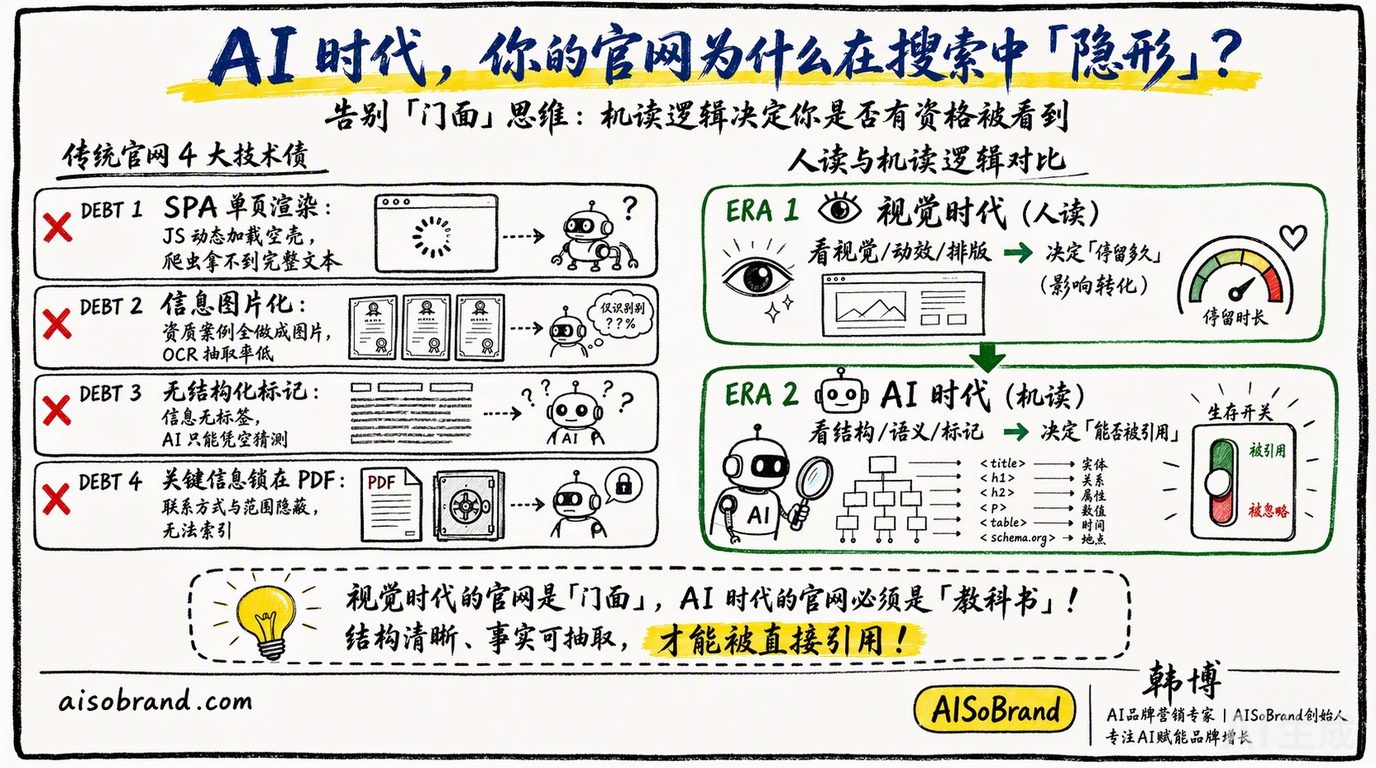
Чтение страницы человеком и машиной — это две разные логики. Человек достраивает смысл по визуалу и контексту; ИИ извлекает сущности, отношения и факты по HTML-структуре и семантической разметке. Когда на сайте есть следующие виды «технического долга», ИИ, как правило, просто пропускает его:
① Рендеринг SPA (одностраничное приложение): контент генерируется динамически JavaScript, сервер отдаёт пустую оболочку, и AI-краулер не получает полного текста.
② Информация в виде картинок: представление компании, лицензии и кейсы оформлены как изображения, OCR-извлечение нестабильно, сущности невозможно связать.
③ Нет структурированной разметки: ИИ не может определить «где продукт, где лицензия, кто руководитель» и вынужден угадывать.
④ Ключевая информация заперта в PDF/JS: контакты и сфера услуг разбросаны по файлам для скачивания, и поисковики, и ИИ с трудом их индексируют.
Одной фразой: сайт эпохи визуала — это «витрина», а сайт эпохи ИИ должен быть «учебником» — с чёткой структурой, извлекаемыми фактами и возможностью прямого цитирования.
II. Технический фундамент AI-читаемости: структурированные данные (Schema Markup)
Самый зрелый и недорогой инженерный способ заставить ИИ «мгновенно понять» вас — структурированные данные (словарь Schema.org + формат JSON-LD). По сути это машиночитаемые «метаданные», встроенные в страницу, которые прямо говорят ИИ: это компания, какие услуги она предоставляет, какие регионы охватывает, какими лицензиями обладает.
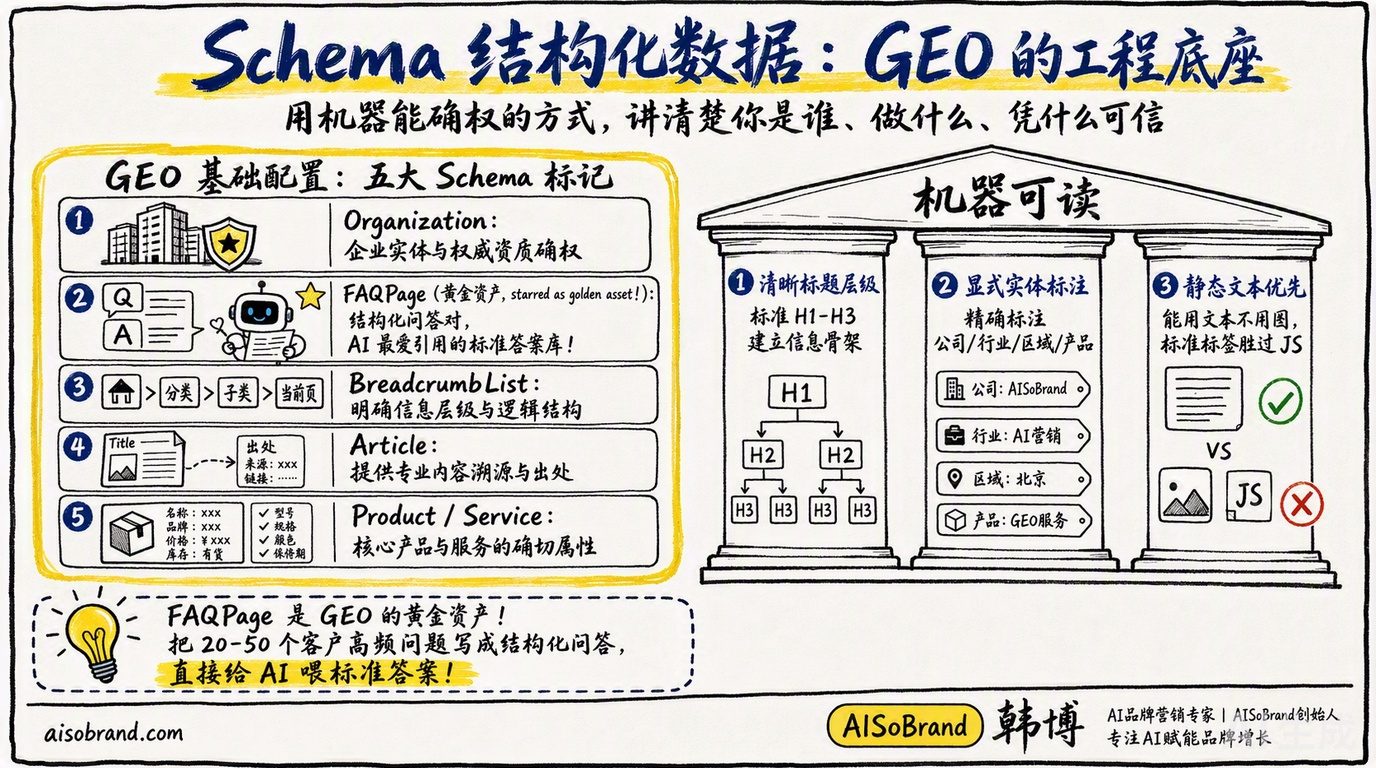
Для корпоративного сайта следующие пять типов Schema — это «базовая конфигурация» GEO:
сущность компании и лицензии
вопрос-ответ · ИИ цитирует охотнее всего
иерархия информации
происхождение контента
Среди них Schema FAQPage — «золотой актив» GEO. Отвечая на отраслевые вопросы, ИИ в первую очередь цитирует «структурированные пары вопрос-ответ», а не прозу. Если оформить 20–50 самых частых вопросов клиентов как пары вопрос-ответ с разметкой Schema, вы по сути подаёте ИИ «библиотеку эталонных ответов» — и вероятность вашего цитирования заметно вырастет.
III. От «чтения человеком» к «чтению машиной»: семантический HTML и субъектизация
Помимо структурированных данных, не менее важен семантический каркас самой страницы. При извлечении информации ИИ сильно опирается на «подсказки» HTML-тегов:
① Чёткая иерархия заголовков: на странице только один H1, разделы — через H2/H3, и ИИ выстраивает по ним «каркас информации».
② Разметка сущностей: явно указывайте «название компании / отрасль / сфера услуг / ключевые продукты», чтобы ИИ сформировал представление «кто вы», а не угадывал из маркетинговых формулировок.
③ Машинная читаемость важнее визуальной привлекательности: где можно — текст вместо картинки, стандартный тег вместо кастомного div, статический рендеринг вместо зависимости от JS.
«AI-читаемость» — это не компромисс «для машины», а способ чётко изложить самые важные факты о компании — кто вы, что делаете, почему вам можно доверять — в форме, которую машина может достоверно зафиксировать.
IV. Корпоративный чек-лист внедрения (техническая сторона)
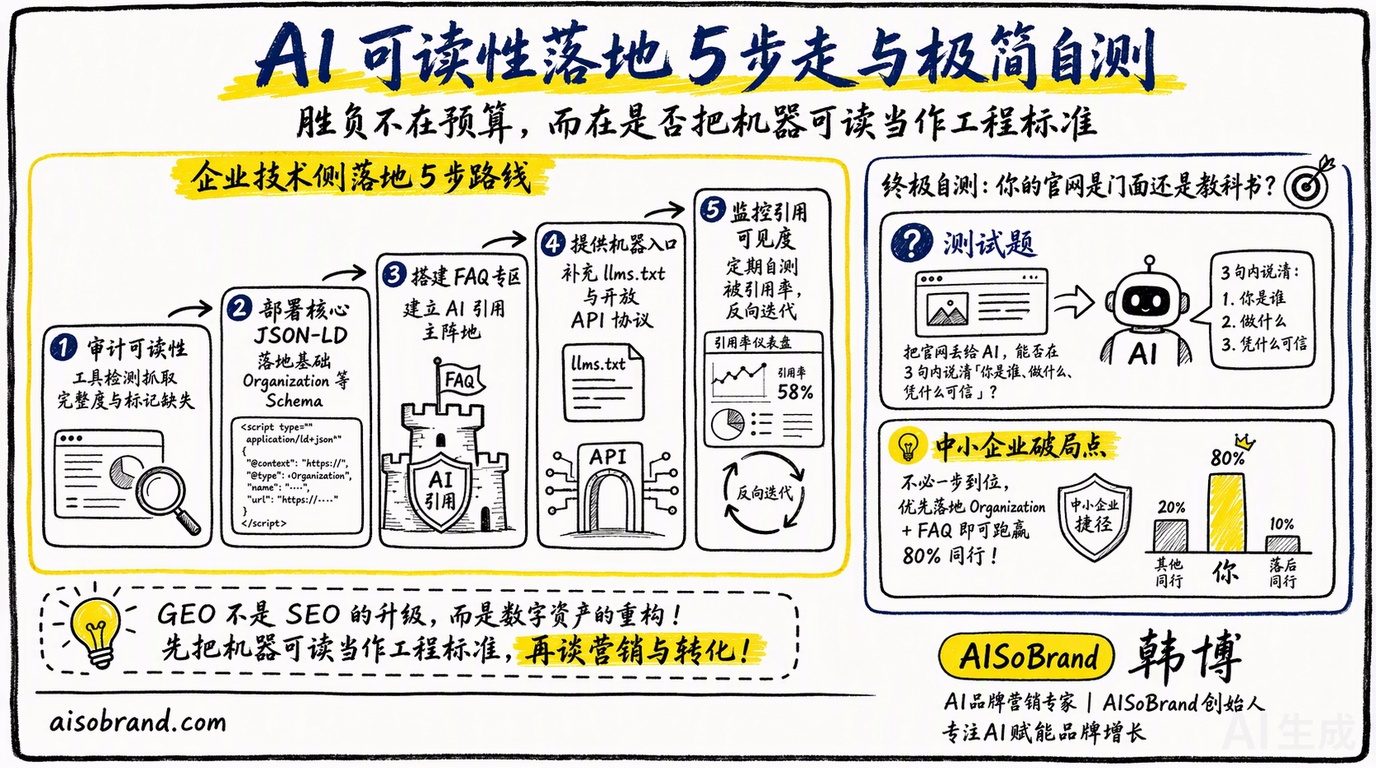
Чтобы превратить сайт в «читаемый для ИИ», не нужно всё переделывать. Стандартная последовательность Chengying Ruanbo для технических команд компаний состоит из пяти шагов:
- Аудит машинной читаемости существующих страницПроверьте с помощью Rich Results, Schema Validator и подобных инструментов: полностью ли краулер извлекает ключевой контент и не отсутствует ли структурированная разметка.
- Внедрение базового JSON-LDНа главной и ключевых страницах разместите три базовых типа Schema: Organization, WebSite, BreadcrumbList.
- Создание структурированного раздела FAQОформите частые вопросы клиентов как базу вопрос-ответ с Schema FAQPage — главный плацдарм для цитирования ИИ.
- Предоставление машиночитаемого входаПостепенно добавляйте llms.txt и открытый API, чтобы между ИИ и корпоративной системой установился стабильный «протокол чтения».
- Мониторинг цитирования ИИ и видимостиРегулярно проверяйте себя отраслевыми ключевыми словами на ведущих AI-платформах, количественно оценивайте «коэффициент цитирования» и итеративно улучшайте Schema и контент.
V. Критерий оценки: ваш сайт — «витрина» или «учебник»
Простой самотест для компании: представьте закупщика, который ничего о вас не знает, и скормите ИИ только ваш сайт — сможет ли ИИ за 3 предложения объяснить «кто вы, что делаете, почему вам можно доверять»? Если нет — ваш сайт всё ещё «витрина», и в глазах ИИ он невидим.
Для малого и среднего бизнеса с ограниченными ресурсами не обязательно делать всё сразу: если внедрить два типа Schema — Organization и FAQ, — вы уже обгоните подавляющее большинство конкурентов. Исход корпоративного GEO часто решает не бюджет, а осознание того, считать ли машинную читаемость инженерным стандартом.
Бесплатно проверьте видимость вашего бренда в AI-поиске
Понимает ли ИИ ваш сайт? Одна бесплатная GEO-диагностика покажет реальную картину цитирования вашего бренда на ведущих AI-платформах.
Бесплатная диагностика →