企业官网的AI可读性:Schema结构化数据如何成为GEO技术底座
过去十年,企业做官网的追求是"视觉冲击力"——炫酷的Banner、流畅的动效、精致的排版。但在生成式AI成为主流信息入口的今天,这套审美标准正在失效。AI爬虫不关心你的页面好不好看,它只关心一件事:你的信息有没有被结构化、能不能被准确抽取和引用。这就是企业级GEO(生成式引擎优化)真正的技术起点——AI可读性。
一、为什么传统官网在AI搜索里"隐形"
我们审计过大量企业官网,发现一个共性现象:内容并不少,但在豆包、DeepSeek、ChatGPT等AI回答行业问题时,这些企业几乎从不被引用。根因往往不是"内容质量差",而是"机器读不懂"。
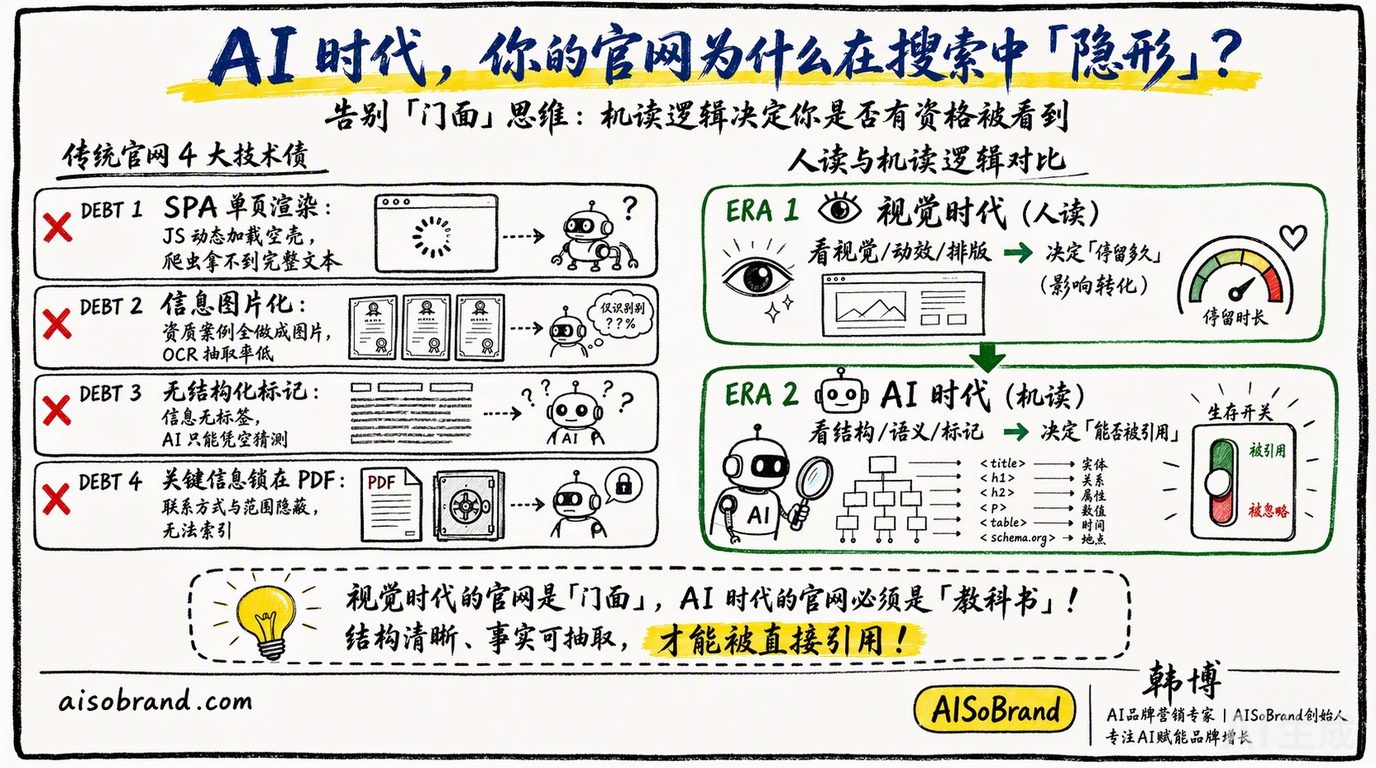
人读页面和机读页面是两套逻辑。人靠视觉和上下文脑补含义;AI靠HTML结构和语义标记来抽取实体、关系与事实。当官网存在以下几类"技术债"时,AI基本会直接跳过:
1. SPA(单页应用)渲染:内容由JavaScript动态生成,服务端返回的是空壳,AI爬虫拿不到完整文本。
2. 信息图片化:公司介绍、资质、案例全做成图片,OCR抽取率低,实体无法关联。
3. 无结构化标记:AI无法判断"哪段是产品、哪段是资质、谁是负责人",只能靠猜测。
4. 关键信息锁在PDF/JS里:联系方式、服务范围散落在下载文件中,搜索引擎和AI都难以索引。
一句话总结:视觉时代的官网是"门面",AI时代的官网必须是"教科书"——结构清晰、事实可抽取、能被直接引用。
二、AI可读性的技术底座:结构化数据(Schema Markup)
让AI"秒懂"你,最成熟、成本最低的工程手段是结构化数据(Schema.org 词汇 + JSON-LD 格式)。它本质是一段嵌在页面里的机器可读"元数据",明确告诉AI:这是一家公司、它提供什么服务、覆盖哪些区域、有哪些资质。
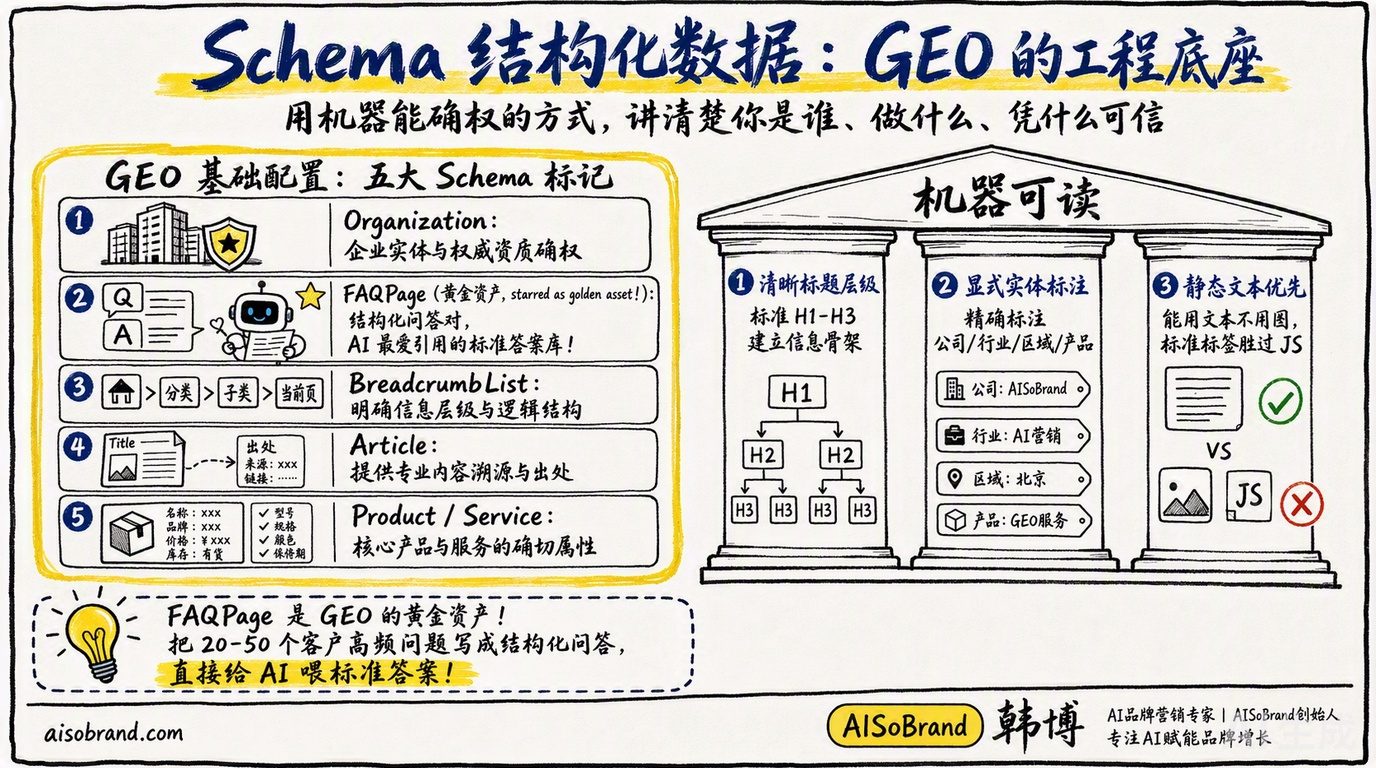
对企业官网而言,以下五类Schema是GEO的"基础配置":
企业实体与资质
问答对·AI最爱引用
信息层级
内容溯源
其中FAQPage Schema 是GEO的"黄金资产"。AI回答行业问题时,优先引用的是"结构化问答对"而非散文。把客户最常问的20-50个问题写成带Schema标记的问答,等于主动给AI喂了一份"标准答案库"——你被引用的概率会显著提升。
三、从"人读"到"机读":语义HTML与实体化
结构化数据之外,页面本身的语义骨架同样关键。AI抽取信息时高度依赖HTML标签的"暗示":
清晰的标题层级:一个页面只有一个H1,章节用H2/H3,AI据此建立"信息骨架"。
实体标注:明确写出"公司名 / 所属行业 / 服务区域 / 核心产品",让AI建立"你是谁"的实体认知,而不是从营销话术里猜。
机器可读优先于视觉友好:能用文本就不用图片,能用标准标签就不用自定义div,能静态渲染就不依赖JS。
"AI可读性"不是给机器看的将就,而是把企业最核心的事实——你是谁、做什么、凭什么被信任——用机器能确权的方式讲清楚。
四、企业级落地清单(技术侧)
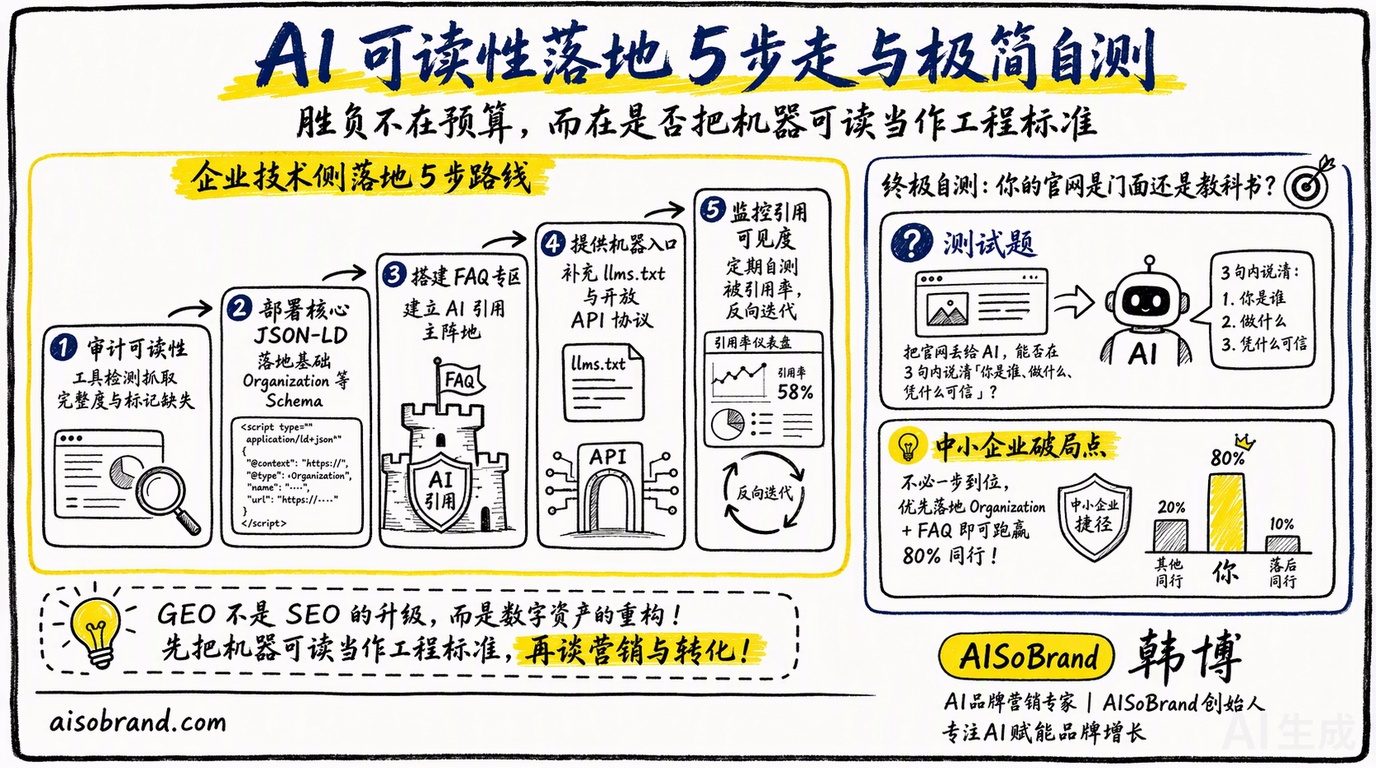
把官网改造成"AI可读",不需要推倒重来。承影软博给企业技术团队的标准动作是五步:
- 审计现有页面的机器可读性用Rich Results、Schema Validator等工具检测:关键内容是否被爬虫完整抓取、是否缺少结构化标记。
- 部署核心JSON-LD在首页与核心页面落地Organization、WebSite、BreadcrumbList三类基础Schema。
- 搭建FAQ结构化专区把客户高频问题写成带FAQPage Schema的问答库,作为AI引用的主阵地。
- 提供机器可读入口逐步补充llms.txt与开放API,让AI和企业系统之间建立稳定的"读取协议"。
- 监控AI引用与可见度定期在主流AI平台用行业关键词自测,量化"被引用率",反向迭代Schema与内容。
五、一个判断标准:你的官网是"门面"还是"教科书"
我们给企业一个极简的自测题:假设一个完全不了解你的采购,只把你的官网丢给AI,AI能否在3句话内说清"你是谁、做什么、凭什么可信"?如果说不清,说明你的官网仍是"门面"——它在AI眼里是隐形的。
对于资源有限的中小企业,不必一步到位:先把Organization和FAQ两类Schema落地,就已经跑赢了绝大多数同行。企业级GEO的胜负,往往不在预算,而在"是否把机器可读性当作工程标准"这一认知差。